登录社区云,与社区用户共同成长
邀请您加入社区
中文分词是自然语言处理的基础技术,其核心任务是将连续的中文字符序列切分为有意义的词语组合。传统基于规则和统计的方法在歧义消解、未登录词识别等方面存在局限,而深度学习通过BiLSTM、Transformer等架构能够自动学习字符级别的上下文表征,显著提升分词准确率。在工程实践中,BiLSTM-CRF模型结合序列标注技术已成为主流方案,通过BMEOS标签体系将分词转化为字符分类问题。针对医疗、法律等专
中文分词是自然语言处理(NLP)的基础技术,其核心是将连续汉字序列切分为有意义的词语单元。传统基于词典的方法面临未登录词(OOV)和歧义切分等挑战,而BiLSTM-CRF等深度学习模型通过捕捉上下文特征显著提升了性能。该架构结合双向LSTM的序列建模能力和CRF的标签转移约束,在MSRA等基准数据集上F1值可达97%以上。工程实践中需重点关注数据预处理(如BIOES标注)、领域适应(医疗/法律文本
cfg模块是Python自带的一个标准库,其中包含了用于读取和写入INI文件的函数和类。INI文件是一种简单的文本文件格式,通常用于存储配置信息。cfg模块可以轻松读取、修改、创建INI文件,以便在程序中动态地配置参数。本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一角。作为通用的Aigc大模型,只是展现它原本的实力。对于颠覆工作方式
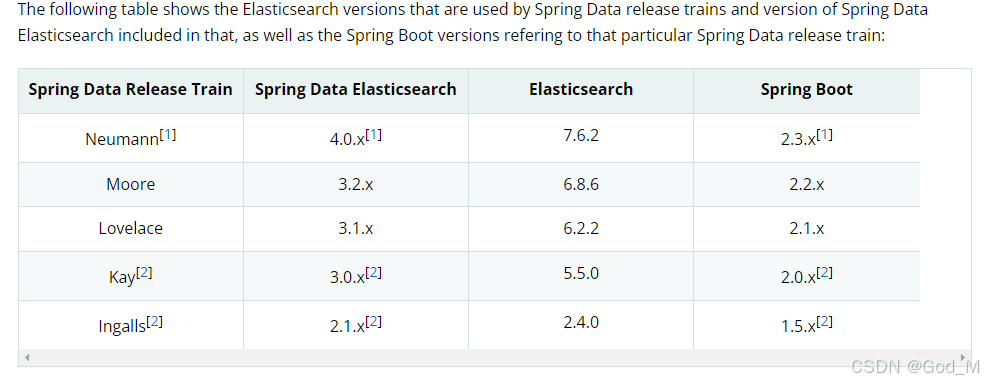
spring-boot版本2.3.7.RELEASEspring-boot-starter-data-elasticsearch版本2.3.7.RELEASEelasticsearch-analysis-ik-7.6.2 中文分词器harbor k8s镜像管理中心ceph 共享存储下图为各软件间的版本对应关系,一定要按照对应关系使用,否则无法成功或出现各种错误。
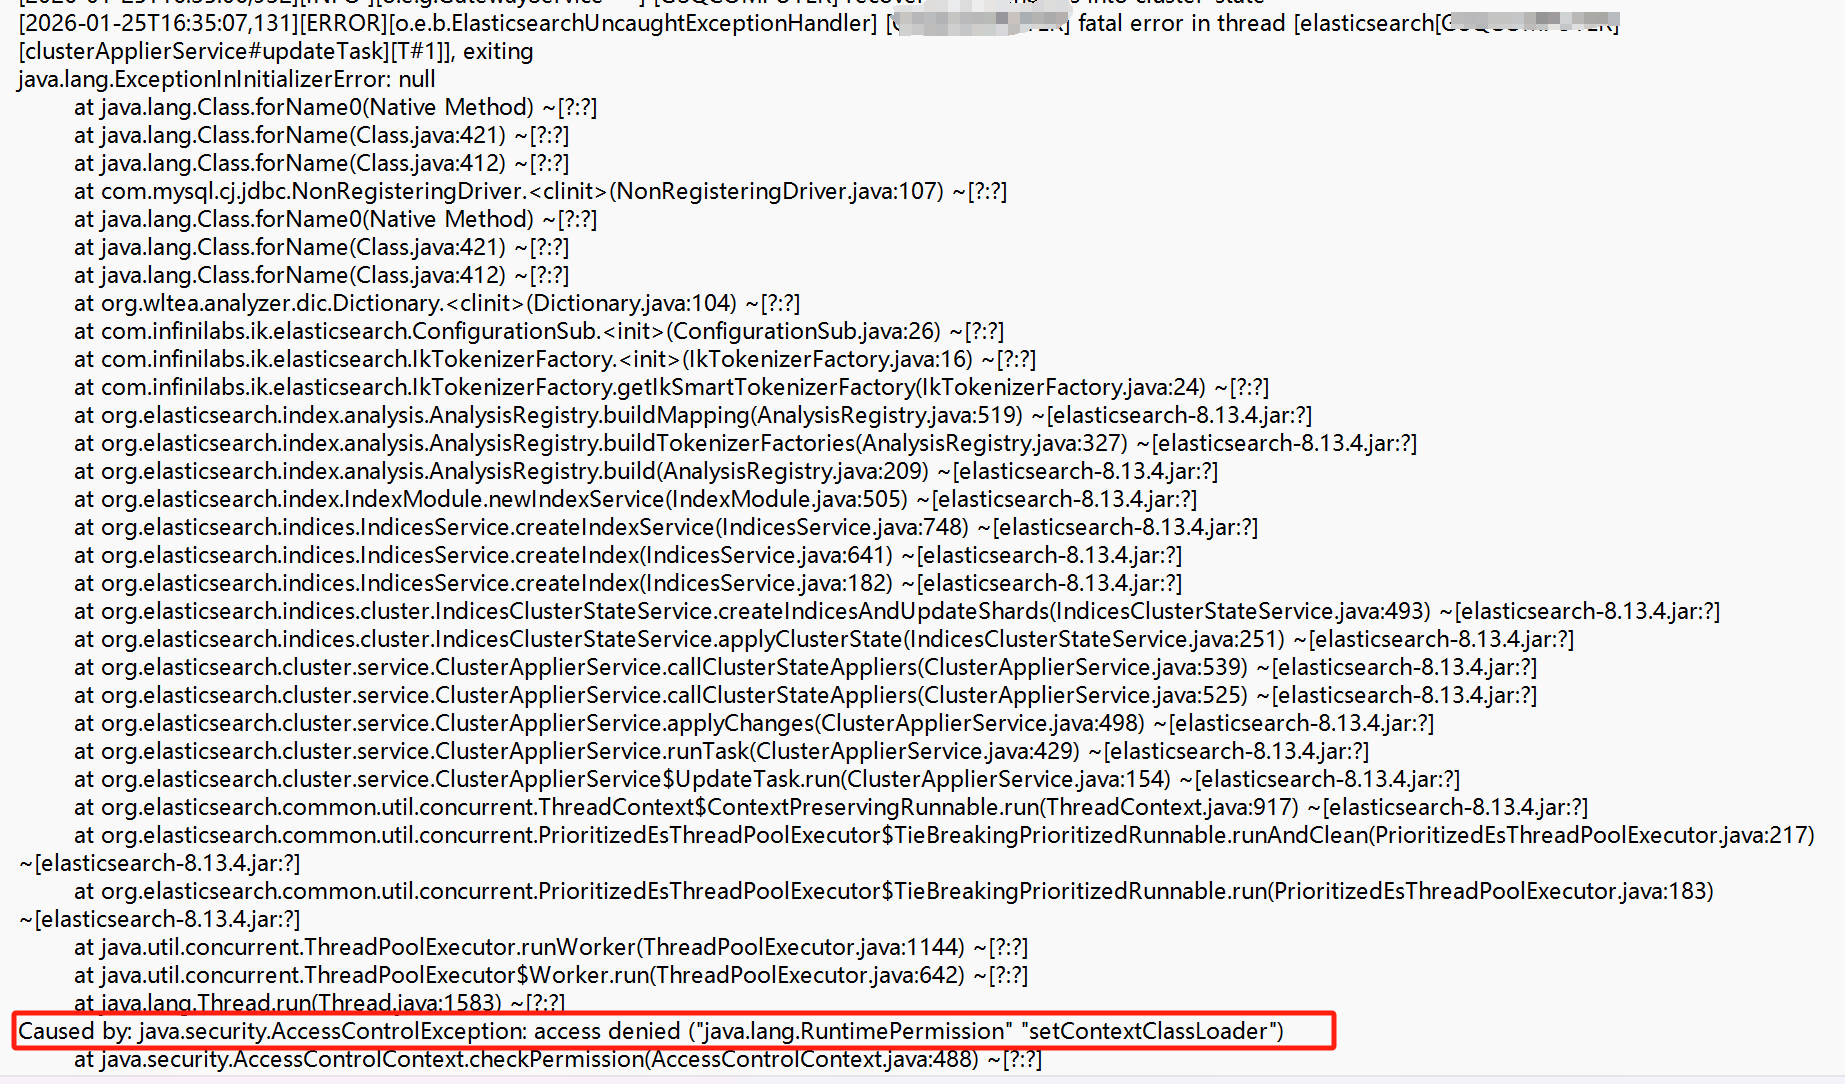
本文介绍了在Elasticsearch 8.13.4中实现IK分词器MySQL词库热更新的方法。通过修改IK源码,添加从MySQL数据库加载扩展词库的功能,解决了文件读取方式性能低的问题。主要步骤包括:1)下载IK源码并添加MySQL词库加载方法;2)配置数据库连接信息;3)实现热更新线程;4)打包部署插件。实施过程中遇到两个主要问题:权限不足和数据库连接异常,通过修改plugin-securit
本文详细对比了Elasticsearch 8.x IK分词器的三种安装方式:在线安装、离线安装和Docker集成,提供了全面的部署指南和性能评测。针对中文分词需求,IK分词器提供ik_smart和ik_max_word两种智能分析模式,有效提升搜索准确率。文章包含版本兼容性检查、安装步骤、配置优化及生产环境最佳实践,帮助开发者快速实现高效的中文文本分析。
IK 自带主词典,业务里那些专有名词、黑话、新词基本覆盖不到。配置文件 IKAnalyzer.cfg.xml 放在 conf/analysis-ik 目录下,里面能挂本地扩展词典、扩展停用词词典,也能挂远程词典。远程那块是热更新入口。配一个 HTTP URL,IK 周期去拉,只要响应里 Last-Modified 或 ETag 有变化,就重新加载词库,不用重启 ES。HTTP 响应得满足两条要求。
本文详细介绍了如何将Jieba分词工具与Elasticsearch 8.x深度集成,构建高性能的中文全文检索系统。通过两种生产级方案(插件化部署和预处理管道)的对比分析,提供了技术选型建议和优化技巧,帮助开发者解决中文分词的核心挑战,提升搜索效果和系统性能。
Elasticsearch(简称 ES)是一个基于构建的分布式搜索与分析引擎。能力说明近实时搜索数据写入后在 1 秒内即可被搜索到(默认刷新间隔)全文检索对文本进行分词、倒排索引、相关性打分,支持模糊、高亮等聚合分析类似 SQL 的 GROUP BY,能在海量数据上做实时统计ES 天然支持分布式部署,一个集群可以横跨数十台服务器,承载 PB 级别的数据,同时保持毫秒级的查询响应。IK 分词器内置了