登录社区云,与社区用户共同成长
邀请您加入社区
数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件)标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["jinpao","shitou"]特别声明:本数据集不对训练的模型或者权重文件精度作任何保证。图片数量(jpg文件个数):1060。标注数
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["fanjian","gangjinwailu","hunningtujinchu","liefeng","mobanaocao","shengwujiangjie","wuzihuoshentou"]对应中文类别名:[ "泛碱", "钢筋外露","混凝土浸出", "裂缝", "模板凹槽","
说明: 6000多张图,已标注txt格式和xml格式 有跑好的现成YOLOv5s权重模型pt文件 训练出来的模型具有较好的识别效果。多样化场景:图像涵盖了多种环境和场景,包括室内、室外、公共场所等,确保模型能够适应不同的背景。研究与教育:用于科研机构的研究以及相关院校的教学,帮助学生和研究人员更好地了解吸烟检测技术。预训练模型:提供了一个已经训练好的YOLOv5s模型,可以直接用于推理或进一步微调
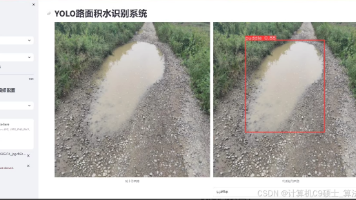
摘要:该项目基于YOLOv8构建了一个路面积水检测系统,包含4524张标注图片(XML和TXT格式),类别为"puddle"。完整流程包括:1) XML转YOLO格式的数据预处理脚本;2) 数据集分割工具(80%训练集);3) YAML配置文件生成;4) YOLOv8模型训练代码(100轮次,512x512分辨率);5) 推理脚本实现目标检测与可视化标注。
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["Dead","Grass","Healthy","Small","Yellow"]数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件)Healthy 占有图片数 = 3007。Yellow
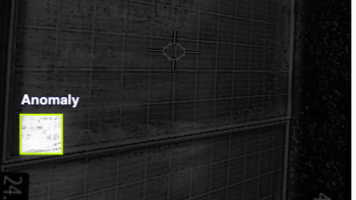
带标注的光伏太阳能板异常数据集,识别率90.5%,9817张图,支持yolo,coco json,voc xml,文末有模型训练代码。
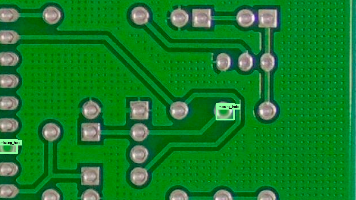
带标注的PCB电路板缺陷数据集,识别率99.2%,可识别6种缺陷,9961张图,支持yolo,coco json,voc xml,文末有模型训练代码。
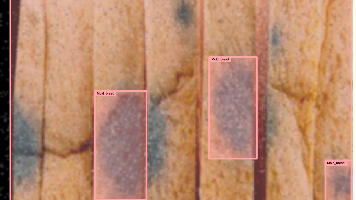
带标注的发霉变质面包数据集,识别率79.1%,924张图,支持yolo,coco json,voc xml,文末有模型训练代码。
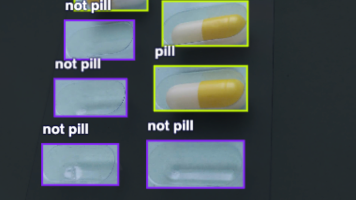
带标注的药品好坏数据集,识别率99.2%数据集,可识别药品的良品次品和空缺,1124张图,支持yolo,coco json,voc xml,文末有模型训练代码。
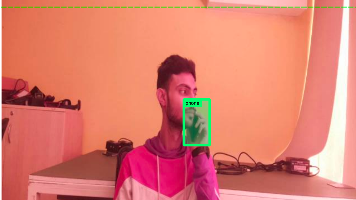
本文介绍了一个高精度带标注的打电话图像数据集,包含9315张图片,识别率达99.5%,支持YOLO、COCO JSON和VOC XML格式。数据集分为训练集(8323张)、验证集(502张)和测试集(490张),经过自动定向和640x640拉伸预处理。特别指出模糊图片是刻意设计的数据增强策略,可提升模型在真实场景中的鲁棒性。提供了YOLO模型训练代码及验证测试脚本,支持目标检测结果的坐标提取和可视
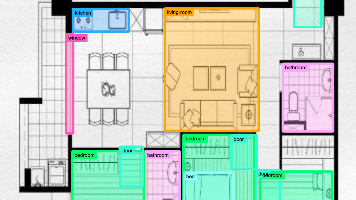
本文介绍了一个装修平面图元素识别数据集,包含303张标注图片,支持识别入口、床、门、窗等8类元素,识别率达93.9%。数据集提供YOLO、COCO JSON和VOC XML格式,包含模型训练代码和验证测试脚本。数据预处理包括图像拉伸至640x640,未使用数据增强。特别指出模糊图片是增强模型鲁棒性的设计策略,可提升在复杂场景下的识别能力。文末提供了模型训练指标和效果图,并附数据集下载链接和YOLO
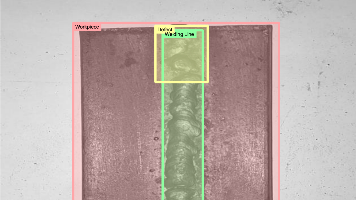
带标注的加工件焊缝缺陷数据集,可识别焊缝,缺陷,工件,识别率96%,1011张图,支持yolo,coco json,voc xml,文末有模型训练代码。
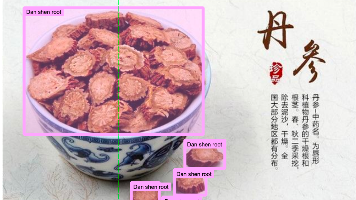
摘要: 本数据集包含21种常见中药材(如天麻、甘草、当归等)的2237张高质量标注图片,支持YOLO、COCO JSON和Pascal VOC XML三种标注格式,适用于中药材自动识别、智能药房管理等场景。数据集分为训练集(71.3%)、验证集(18.6%)和测试集(10.1%),经预处理统一为640×640像素。基于YOLOv8训练的模型平均精度(mAP@0.5)达73.8%,推理速度约15ms
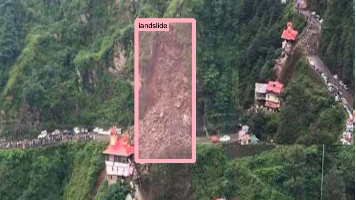
本文介绍了一个高质量的山体滑坡检测数据集,包含974张标注图像,识别率达78.1%,支持YOLO、COCO和Pascal VOC格式。数据集按标准分为训练集(89.3%)、验证集(7.9%)和测试集(2.8%),并经过自动定向和尺寸统一预处理。数据集中模糊图像被设计为增强模型鲁棒性的策略,能提升复杂场景下的识别能力。文中提供了YOLO模型训练代码及验证示例,帮助用户快速应用于滑坡检测和地质灾害监测
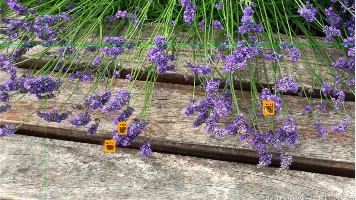
摘要:该数据集包含8080张标注蜜蜂图像,支持YOLO、COCO JSON和VOC XML格式,识别率达88.6%。数据集分为训练集(5640张)、验证集(1604张)和测试集(836张),图片预处理为640x640拉伸尺寸。提供YOLO模型训练代码和验证测试脚本,包含模糊图片以增强模型鲁棒性。数据标注示例和训练指标参数已展示,可通过链接下载完整数据集。
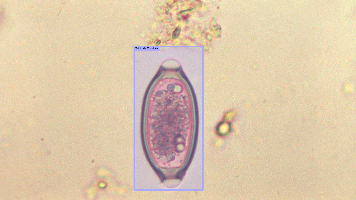
摘要: 该研究提供了一个包含2110张图像的寄生虫数据集,涵盖8种常见寄生虫类型(如人蛔虫、钩虫属、血吸虫等),支持YOLO、COCO JSON和VOC XML格式,识别率达83.2%。数据集按70%训练集、20%验证集和10%测试集划分,图像预处理为640x640分辨率,无数据增强。文中强调了模糊图像对提升模型鲁棒性和泛化能力的作用,并提供了YOLOv8训练代码及验证脚本。用户可通过下载数据集和
etree是一个Python库,它是对标准库中ElementTree的增强版本,支持更高效率的XML解析和操作。由于它是采用C语言编写的,因此在处理大规模XML数据时,与ElementTree相比可以显著的提高性能。同时,etree在API设计上更加灵活,提供了更多可扩展性的方法和功能。本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一
文章分析了qwen coder和kimi在处理XML数据时的代码差异。发现两者初始版本都因未限定查找范围导致数值解析错误:qwen coder错误地查找了inlineStr标签,kimi则使用了不完善的指针转换技巧。通过修改代码,限定查找范围为当前列后,两者都能正确解析数据。性能测试显示qwen coder的代码效率更高(16秒完成),而kimi耗时较长(超过2分钟)。结果表明,高效的代码需要更复
在业务中如果dao层搭配了mybatis,那么通常会将一些业务查询写入到xml中,并且在过滤一些业务条件时会使用OGNL表达式比如下面这段OGNL表达式</if></if>可以看到在表达式中是通过xxx.xxx的方式取值的;先说结论,通过get方法获取的值。
maven-shade-plugin,其主要功能是在项目构建生命周期中的package阶段执行,用于创建一个“影子”JAR(也称为Uber JAR),即将项目的所有依赖项合并到单个可执行的JAR文件中。这样做的好处是简化了部署和运行过程,因为所有依赖都已包含在内。<shadedClassifierName>shaded</shadedClassifierName>指定了这个shade处理后的art
真正原因不是jwt使用错误 或者jwt版本过低,真正原因是jdk版本高于9,我使用的版本jdk17 jwt版本0.9.0,进行jwt后出现报错。jdk版本超过9后不再自动导入这两根文件的jar包,手动导入即可。
该条错误是由于精轨数据的路径不对或者是有冲突导致的,可以在envi-preferences和sarscape-preferences中修改一致,如果精轨数据在k:\jinggui\AUX_POEORB文件夹下,可以设置路径为k:\jinggui。
这篇XML文档详细描述了Maven项目对象模型(POM)的标准结构和属性。主要内容包括:项目基本信息(groupId、artifactId、version等)、构建配置、依赖管理、开发者信息、问题追踪系统配置、持续集成设置、邮件列表、许可证声明等。文档对每个XML标签都提供了详细的注释说明,包括parent父项目继承、packaging项目类型、issueManagement问题管理系统、ciMa
java 生成 xml
XmlElement(name = "shiyan") // 显式指定XML元素名称。@XmlElement(name = "user") // 显式指定XML元素名称。@XmlElement(name = "name") // 显式指定XML元素名称。@XmlElement(name = "ces") // 显式指定XML元素名称。@XmlElement(name = "age") // 显式指
【代码】日志打印配置:logback-spring.xml配置;info和error完全区分了,并且按时间拆分了。
原本是写resultType的,如下图,结果返回的数据extendMessage为null。改成resultMap并指定typeHandler就有返回结果了。
XML 文件在解析时会将五种特殊字符进行转义,当不希望语法被转义时,就需要进行特别处理,参考HTML字符转义规范Myabtis 中五个特殊字符。引用地址:https://blog.csdn.net/qq_37284798/article/details/132617245。[CDATA[ ]]>原始符号符号含义。三 方法二:使用转义字符。原始符号转义字符。"英文双引号。’英文单引号。
AOP,Aspect Oriented Programming,面向切面编程,是对面向对象编程OOP的升华。OOP是纵向对一个事物的抽象,一个对象包括静态的属性信息,包括动态的方法信息等。而AOP是横向的对不同事物的抽象,属性与属性、方法与方法、对象与对象都可以组成一个切面,而用这种思维去设计编程的方式叫做面向切面编程动态代理技术,在运行期间,对目标对象的方法进行增强,代理对象同名方法内可以执行原
且运行时产生的日志文件会以每小时进行切割进另一个日志文件存储。将控制台指定级别的日志写入本地指定目录./logs下。
maven-3.9.12的conf配置settings.xml
大家好,我是小李,一名刚毕业三个月的Java后端开发。说出来不怕大家笑话,在学校的时候,我是个坚定的"SSH党"——Spring、SpringMVC、Hibernate三大框架用得那叫一个溜。直到有一天,导师让我新建一个Spring Boot项目,我整个人都懵了。事情是这样的。那天导师说:"小明啊,现在公司都用Spring Boot了,你也学一学,下午给我个Demo看看。"我心想,这有什么难的,不
核心结论:布局文件 (.xml)≠必须对应 Java 文件,仅 Activity/Fragment 页面需一一绑定(规范),复用型布局无需专属 Java 文件;绑定规则:1 个 Java 文件可绑定多个布局(动态切换),1 个布局可被多个 Java 文件复用(如标题栏);逻辑处理:所有控件逻辑由「当前页面的 Java 文件」处理,复用布局无独立逻辑文件;命名规范:Activity/Fragment
在 MyBatis 的传统开发模式中,XML映射文件是核心,但随着项目复杂度提升,大量 XML 文件会增加维护成本。MyBatis 提供的注解开发模式,可直接在 Mapper 接口方法上标注注解来编写 SQL,无需编写 XML 映射文件,极大简化了开发流程。本文将全面讲解 MyBatis 注解开发的核心用法,包括基础 CRUD、动态 SQL、关联查询,对比 XML 模式的差异,让你快速掌握注解开发
这个商城项目虽然用了传统的SSH框架,但包含了电商系统常见的核心模块。今天咱们聊聊基于SSH框架实现的系统,这个项目最有趣的地方在于它把Struts2的页面跳转、Spring的依赖注入和Hibernate的ORM特性玩得挺溜。注意这用的是Action级别的成员变量,配合Struts2的Session机制,实际开发要考虑线程安全问题。包含详细的文档、PPT演示,运行录屏,适合初学者参考指导。包含详细
ViewModel是Jetpack架构组件的核心类,专门负责存放和处理与UI相关的数据和业务逻辑ViewModel的生命周期独立于Activity/Fragment。LiveData是Jetpack架构组件的类,本质是一个「持有数据的容器」可观察:数据发生变化时,会自动通知所有「观察它的对象」(比如Activity);生命周期感知:能自动感知View层(Activity/Fragment)的生命周
Hutool XML工具
中国Java后端技术栈长期停留在Java 8+MyBatis组合,主要源于稳定性需求、成熟生态和路径依赖。Java 8作为首个LTS版本,配合Spring Boot 2.x和各类中间件形成最稳定的生产环境;MyBatis则因其SQL掌控性强、适合复杂查询场景,成为金融/互联网行业首选。这种技术惯性由阿里系带动,加之人才市场供给充足,形成了"Java 8+Spring Boot+MyBat
MyBatis-Plus作为MyBatis的增强工具,有效解决了大型项目中手写XML SQL的痛点。它通过BaseMapper提供零XML的CRUD操作,减少冗余代码和启动开销;LambdaQueryWrapper避免SQL拼写错误;内置分页、逻辑删除等功能统一团队规范;同时保持原生MyBatis的灵活性,可混合使用XML处理复杂查询。其代码生成器、性能分析插件等工具进一步提升开发效率,成为大型项
Bean Transfer 是一个基于 XML 配置的对象到对象映射工具,专为复杂报文转换场景设计。该框架通过声明式的 XML 配置实现对象映射,无需修改实体类即可完成复杂的转换逻辑。项目地址:bean-transfer: 基于配置文件实现属性复制,基于SPEL,支持复杂表达式。报文转换(如 HTTP 请求/响应转换)异构系统之间的数据对接需要频繁变化的字段映射关系跨层级、嵌套对象的复杂映射简单的
本文对比了三种主流数据交换技术:Protobuf、JSON和XML。首先从定义上区分了三者的特性:Protobuf是二进制序列化协议,JSON是轻量级文本格式,XML是标记语言。然后通过用户信息案例展示了三种技术的语法差异:Protobuf需预定义.proto文件,JSON采用键值对结构,XML使用标签化格式。最后在C++中演示了三种技术的序列化/反序列化实现,包括Protobuf的二进制高效处理
使用 注解 实现 增删改查,注解是:@Insert,@Delete,@update,@Select使用 xml 实现 增删改查,标签是:,,,# 数据库连接配置# 数据库连接配置password : 123456 driver - class - name : com . mysql . cj . jdbc . Driver # 配置打印 MyBatis ⽇志。
看到上述的报错信息,注意 xml文件,配置文件 ,接口的名字,是否相关参数都正确。总的来说,还是建议使用第三种方式,配置文件,驼峰自动转换(前提是遵守命名规范)的方式,用于 对象的属性和数据表的字段 的映射。配置文件,自动映射,我开头的配置文件已经配置好了。配置文件,配置好 xml 的配置信息接口的名字 和 xml文件中namespace 需要对应xml文件存在的包名,xml文件的后缀结尾名,要和
“http://www.springframework.org/schema/context”是命名空间,不过是虚拟的地址,在spring-context\5.3.7\spring-context-5.3.7.jar!上述步骤每一步都是紧密相连的,逻辑清晰,实际上并不难,不懂的代码是可以参考别的已用的,比如说是上一节我们讲的Contex。它也是虚拟地址,映射到spring-context\5.3
在MyBatis-Plus开发中,XML动态SQL的条件判断是核心功能之一。本文将详细介绍如何使用<choose><when>标签实现类似Java中if-else的逻辑控制,并提供完整的代码示例。
本文通过一个简单的 Maven 实验,实证了 Spring 内部的“图纸置换理论”:当冲突发生时,Spring 是如何通过覆盖 BeanDefinition 来抹除旧配置痕迹的。
JDBC是Java操作关系型数据库的标准API,提供连接数据库、执行SQL语句等功能。核心对象包括Connection、PreparedStatement和ResultSet,其中PreparedStatement支持预编译SQL,能防止SQL注入并提高性能。MyBatis作为持久层框架,简化了JDBC开发,支持注解和XML两种SQL配置方式。注解适合简单SQL,XML适合复杂SQL。MyBati